Har vi använt AI på fel sätt? Data Experience och AI i processer
Tänk på en vanlig uppgift: en produkt saknar nettovikt. Den som upptäcker det vet sällan var värdet ska in. Det blir ett ärende, ett mejl till rätt person, en väntan på svar och till sist någon som navigerar rätt i rätt system. Själva ändringen tar tio sekunder. Allt runt omkring kan ta dagar. Ibland veckor.
Under de senaste åren har nästan alla organisationer infört AI på ett eller annat sätt. Ändå ser exemplet ovan ofta likadant ut som för fem år sedan. Det säger något viktigt om var vi har adapterat AI hittills. Och var nyttan egentligen finns.
Var vi står idag: AI på fel ställe?
Det mesta av vårt arbete är inte själva arbetet. Enligt Asanas Anatomy of Work Global Index (en studie baserad på nästan 10 000 individer) går 58 procent av arbetsdagen åt till work about work: att samordna, leta efter information, fråga runt och följa upp.
Vi ser samma mönster. Majoriteten av tiden i en vanlig process går idag åt till att förklara vad som ska göras, skicka vidare, vänta på svar och leta efter rätt system, vy och fält. Själva utförandet är ofta den minsta delen.
Och det är just utförandet som de flesta har lagt in AI i. Vi låter den skriva produkttexter, klassificera artiklar, formulera mejl och skriva kod. Det är värdefullt, men det effektiviserar den minsta delen av jobbet. Vi tror att man kan vända på det: låta AI ta hand om saker som kommunikation och navigation, så att vi människor kan lägga vår tid på det som faktiskt skapar värde. Där finns den stora produktivitetsvinsten.
Samtidigt har vi ofta låtit AI gå för långt åt andra hållet: vi ber den om strategiska råd och låter den formulera beslut. Det är här vi tror att vi har använt AI på fel sätt. AI är som bäst när den hjälper oss fatta välgrundade beslut. Inte fatta dem åt oss.
Silos och power users: den dolda skatten
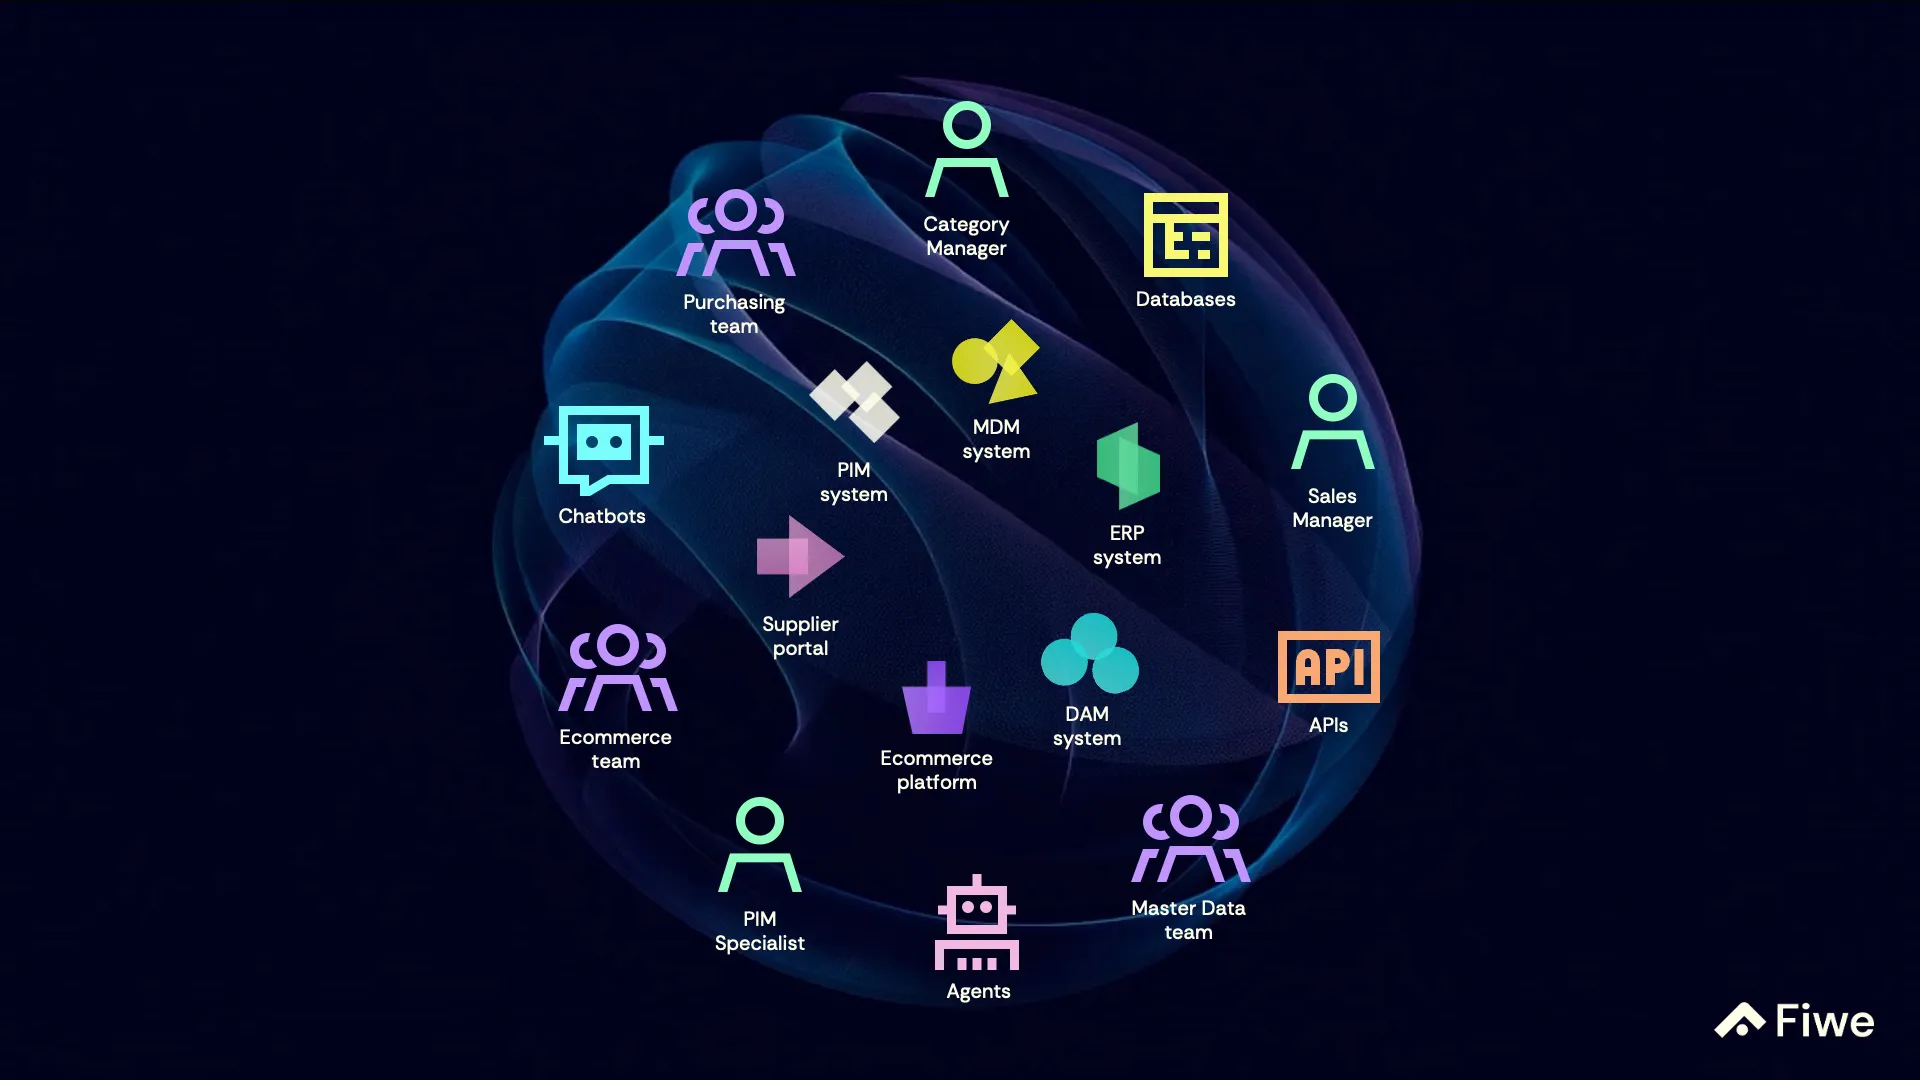
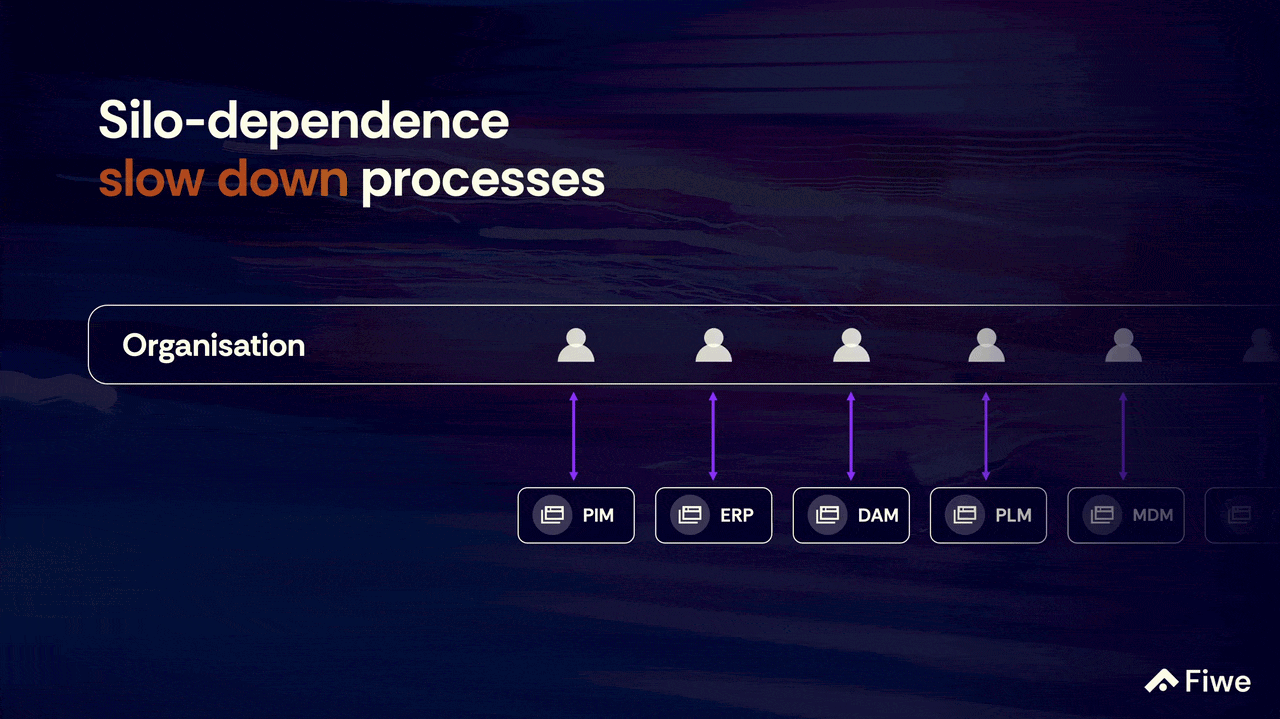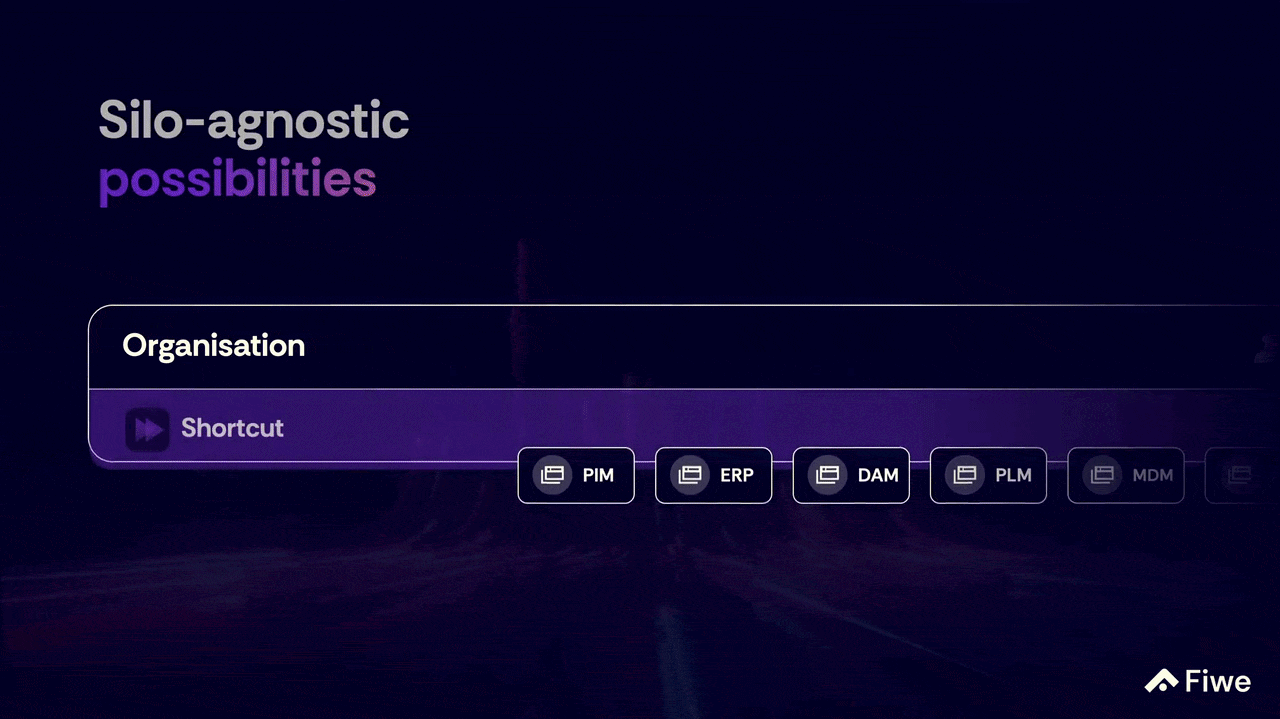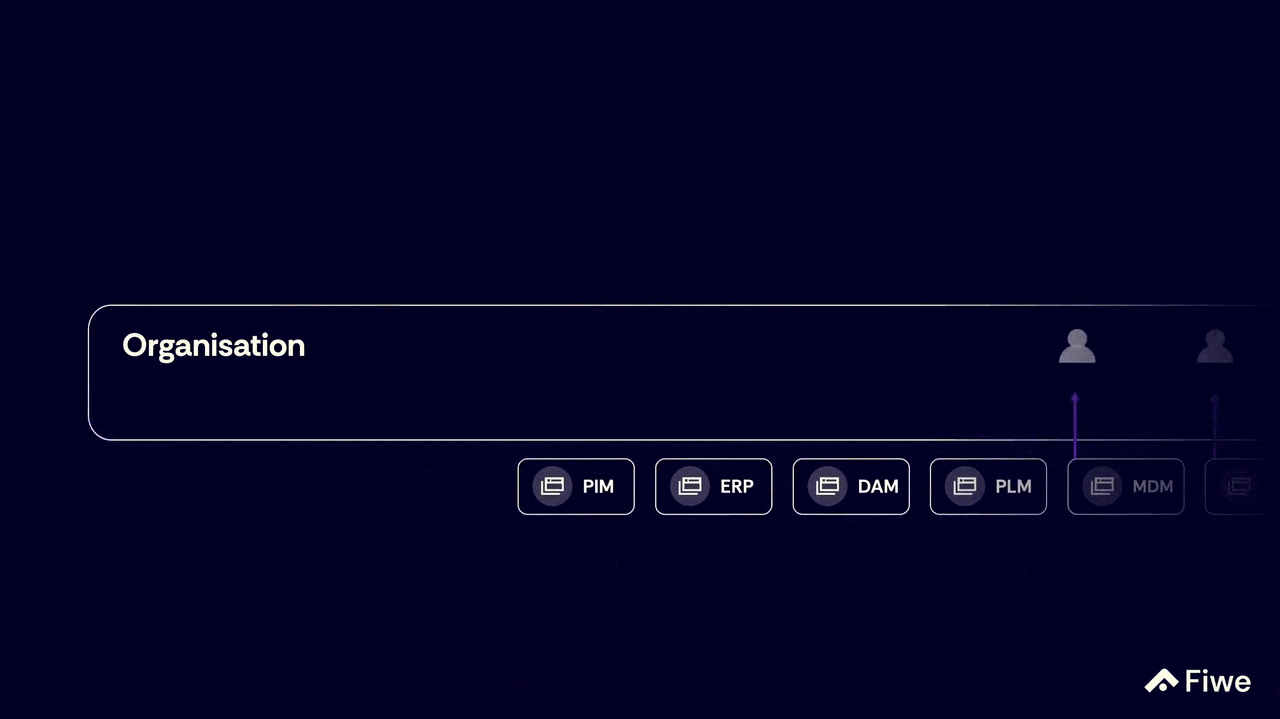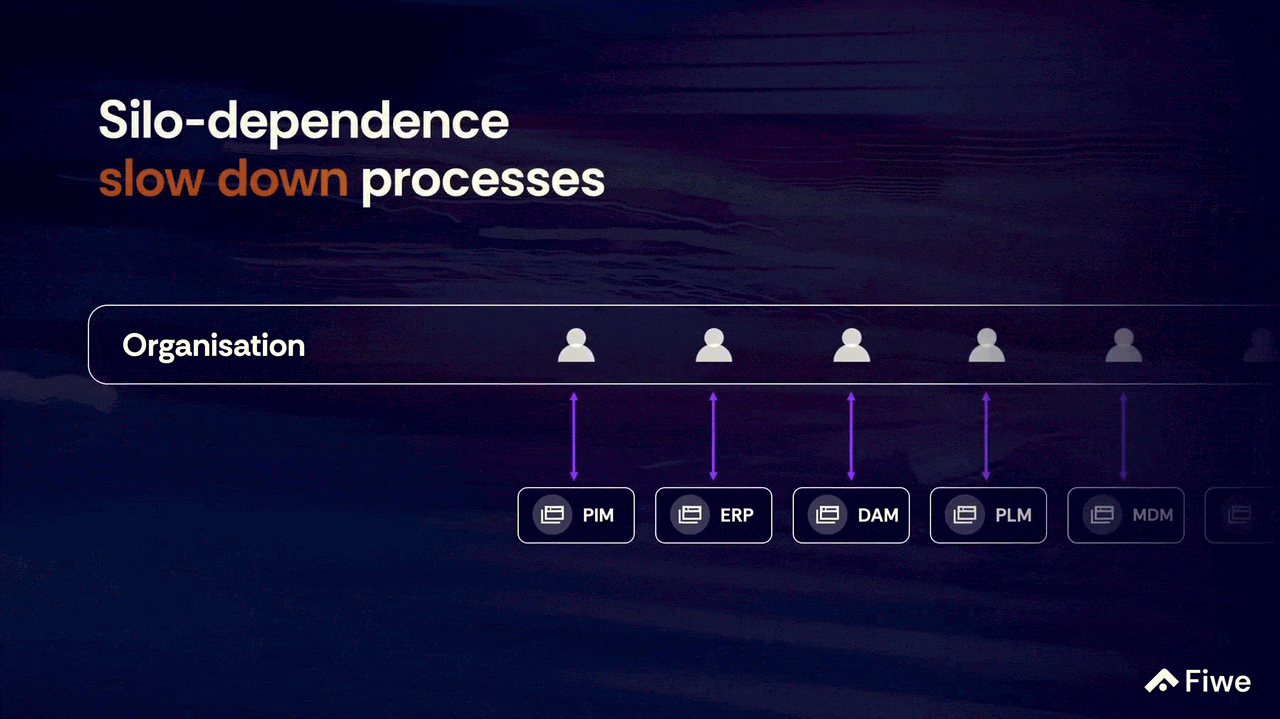
I de flesta större organisationer lever data i stabila och välstrukturerade system: ERP, PIM, MDM, e-handel och leverantörsportaler. Det är bra, men varje system har sitt eget gränssnitt och sitt eget språk och endast ett fåtal kan dem på riktigt.
Resultatet är ett beroende av power users. Den som säljer, köper in eller leder ett affärsområde måste gå via någon som hittar rätt. Vi brukar kalla det för en siloskatt och en navigationsskatt: kostnader som inte syns i någon budget, men som bromsar hela organisationen i en tid där allt går snabbare.
I vårt poddavsnitt Utbenat: Datasilos pekar Sebastian Mildgrim på att silos sällan handlar om tekniken i sig, utan om att avdelningar har olika behov: "Våra olika behov skapar olika dialekter av data". Varje del av verksamheten optimerar sin egen värld, ofta på bekostnad av helheten. Lösningen är inte att riva väggarna mellan systemen och avdelningarna, utan att bygga kommunikation mellan dem.
Vart vi är på väg: från att leta till att göra
Data Management handlar om "baksidan": att få data strukturerad, korrekt och på rätt plats. Det arbetet är viktigare än någonsin. Men för att datan ska skapa värde behöver även "framsidan" fungera, det vi kallar Data Experience: hur människor faktiskt hittar, förstår, använder och litar på data i sitt dagliga arbete.
I en väl fungerande Data Experience behöver användaren inte veta i vilket system informationen bor. Hen beskriver vad som ska göras och resten löser sig.
Ett exempel i nationell skala
Låt oss ta ett konkret exempel. I slutet av september 2026 lanserade USA:s regering America.gov, en gemensam ingång till de federala myndigheterna. Istället för att navigera mellan tusentals webbplatser ställer medborgaren sin fråga i en chatt, som hämtar svaret från omkring 29 000 officiella källor.
Men det intressanta är nästa steg. Från början av 2027 ska medborgare kunna ansöka om, anmäla sig till och följa ärenden direkt i samma gränssnitt. Från att fråga till att göra, utan att ens behöva veta vilken myndighet som äger frågan. Det är precis det skiftet som väntar inne i våra organisationer.
Byggstenarna som gör skiftet möjligt
Flera tekniska trender gör skiftet möjligt just nu.
Den första är MCP (Model Context Protocol): en öppen standard för hur AI kopplas till befintliga system, ofta kallad "USB-C för AI". Istället för en specialbyggd integration för varje system berättar systemet själv för AI:n vilken data som finns och vad som går att göra. Ta ett PIM-system som exempel: där kan en AI hitta produkten som saknar nettovikt, se att fältet är tomt och föreslå ändringen. När flera system talar samma språk mot AI kan en och samma uppgift hämta underlag från alla samtidigt.
Den andra är generativa gränssnitt: istället för att användaren letar sig fram till rätt skärm skapas ett gränssnitt för just den uppgift som ska göras. Det är redan verklighet. I oktober 2026 började OpenAI rulla ut GPT-6 med Intelligent UI i ChatGPT, där svaren byggs upp av text, grafik, knappar, formulär och diagram anpassade efter frågan, för mer än 1,2 miljarder användare i veckan. Tanken är att mjukvaran ska anpassa sig efter människorna, inte tvärtom. Samma princip kommer att flytta in i verksamhetens egna system: bara de fält, fakta och knappar som behövs, hämtade från de system där de hör hemma.
Den tredje är kontext och minne: en AI-modell är aldrig bättre än vad den vet om situationen i form av exempelvis era begrepp, era regler och er historik. Här sker mycket just nu, med tekniker och metoder för att ge modellerna rätt kontext i rätt ögonblick och ett minne som håller över tid, för både individer, avdelningar och organisationer. Det är ett område vi själva arbetar mycket med, eftersom det gör AI både effektivare och betydligt mer kapabel. Vi har pratat om detta i bland annat poddavsnitten Varför minns inte en AI som en människa? och Utbenat: Kontext för den som vill fördjupa sig ytterligare.
Den fjärde är beslutsmodeller: AI som inte skriver långa svar, utan väljer mellan ett antal givna alternativ på bråkdelen av en sekund. OpenAI presenterade sitt Decisions API i slutet av september 2026 och i oktober släppte Cloudflare sina öppna Clef-modeller i samma kategori, som konkurrent till bland andra Jev från TypeSafe. Gemensamt är att AI:n tolkar en situation och föreslår ett tydligt nästa steg, medan människan och verksamhetens regler behåller beslutet.
Till det kommer fler byggstenar som mognar snabbt: öppna standarder som gör det enklare att koppla AI till befintliga system och agenter som kan arbeta direkt i webbgränssnitt. Var för sig är de tekniska framsteg. Tillsammans pekar de åt samma håll.
Resultatet: AI förstår vad som ska göras, tar fram rätt underlag och visar ett enkelt gränssnitt där människan bekräftar och genomför.
Så ser det ut i praktiken: Shortcut
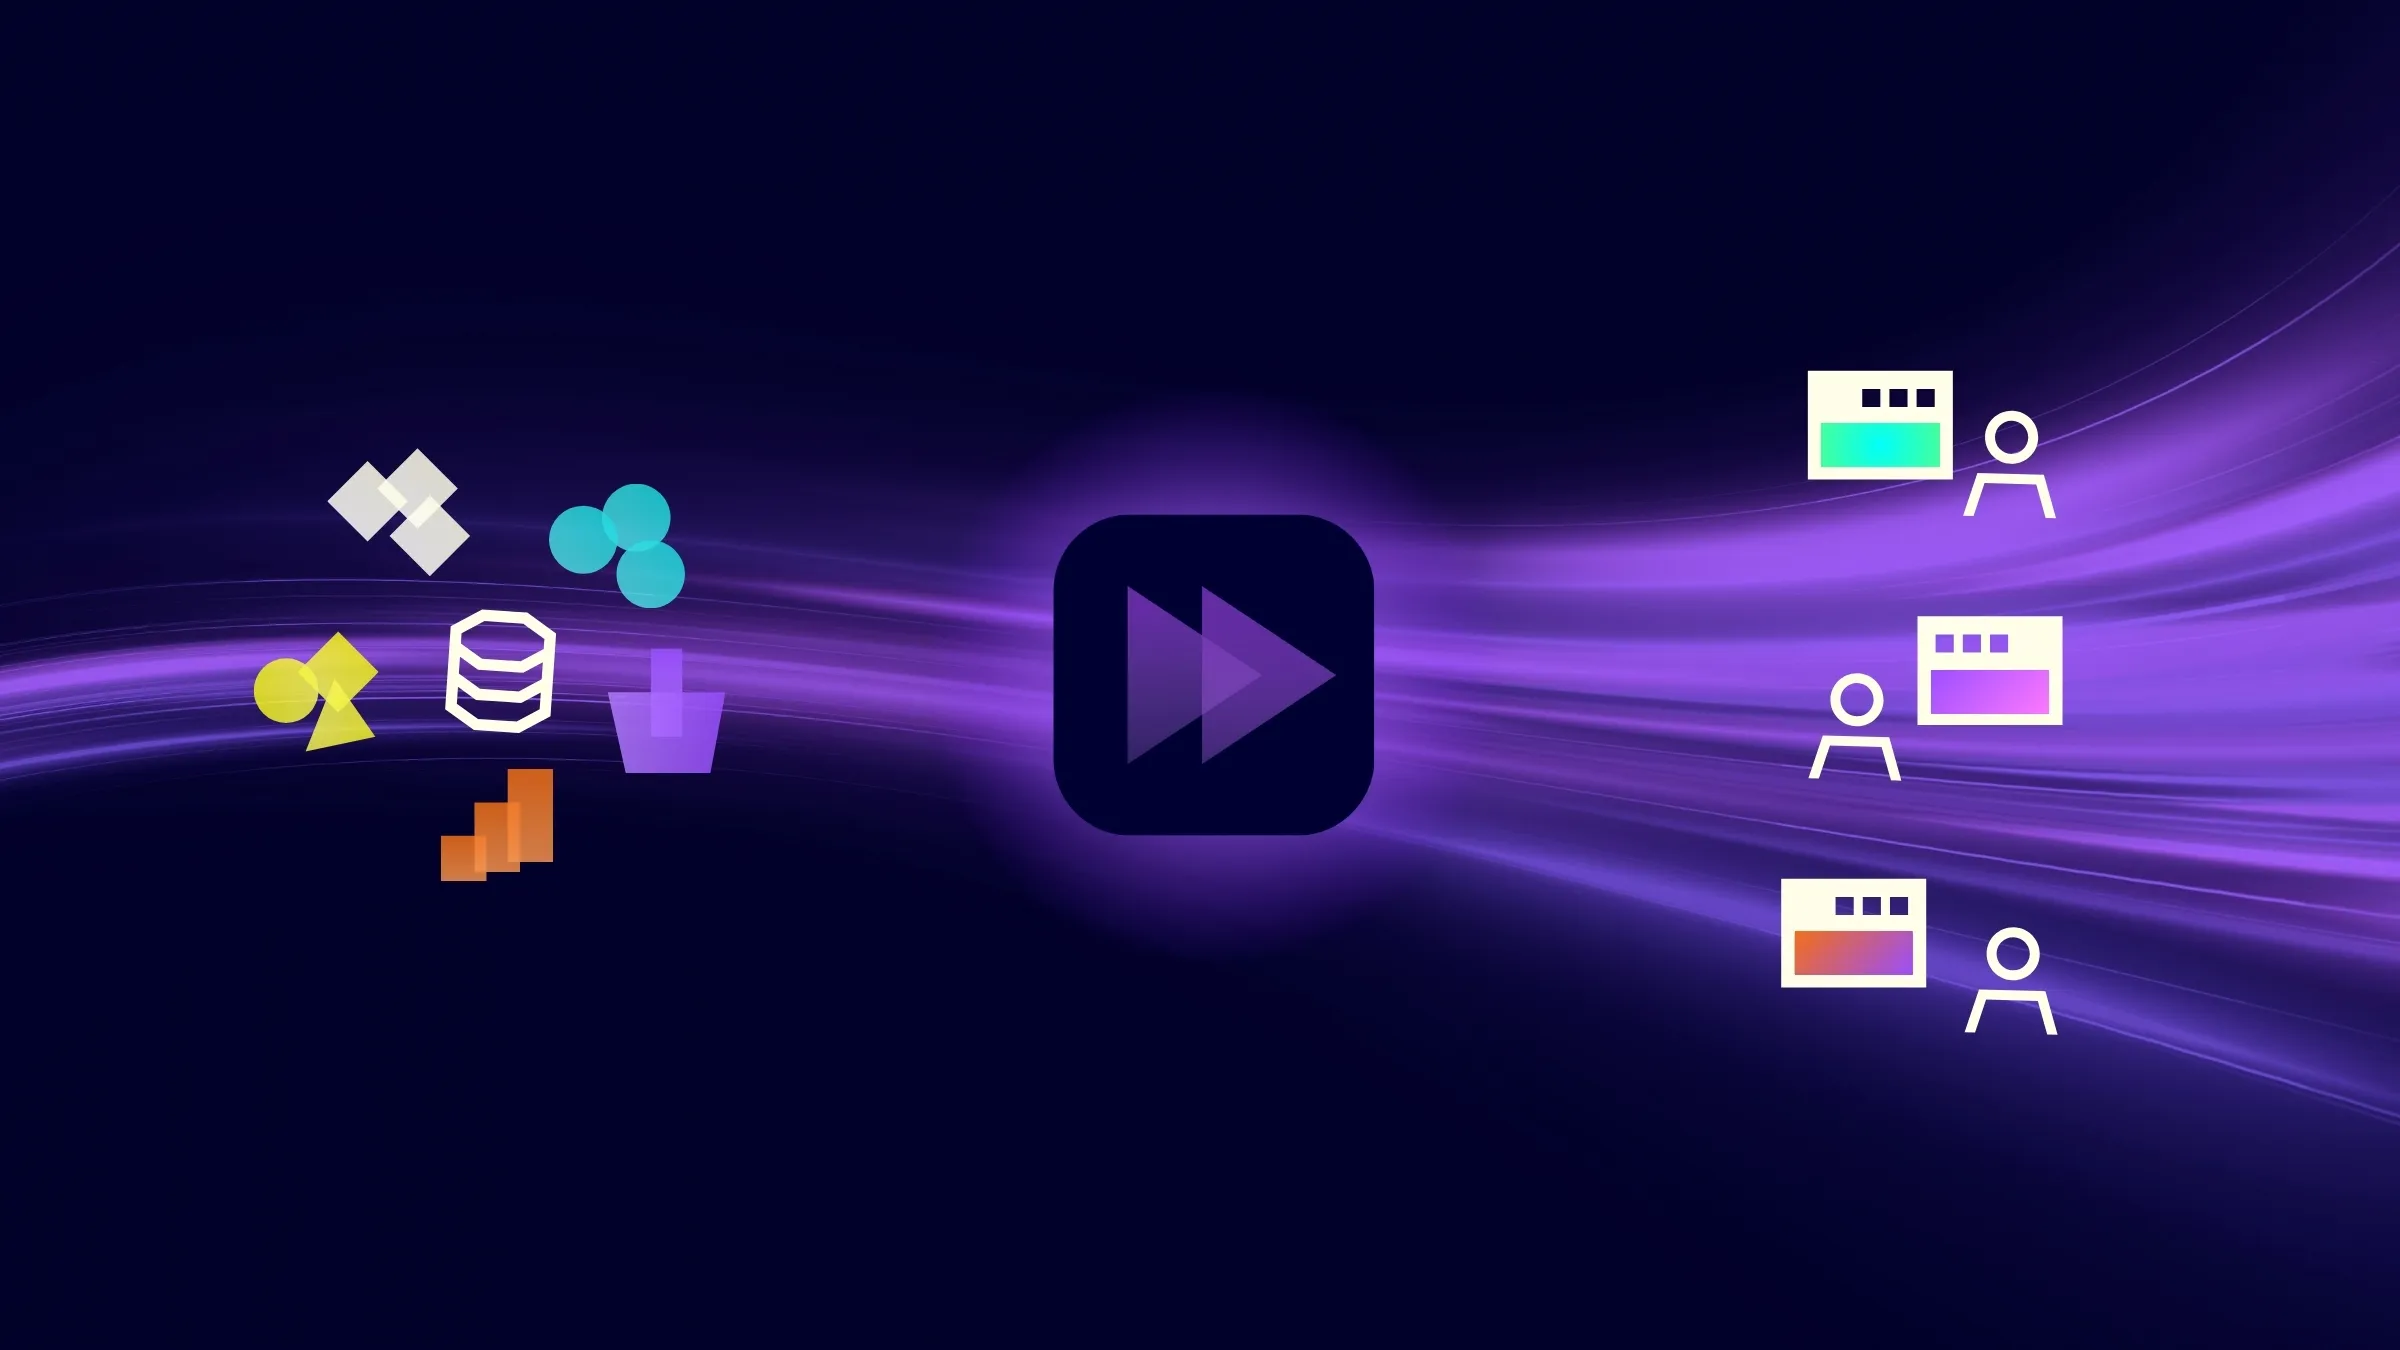
På Fiwe har vi senaste tiden labbat med något vi kallar Shortcut som ska göra just detta inne i organisationer. Shortcut är ett smart lager mellan användaren och de system där datan bor.
Ta exemplet med den saknade nettovikten. Istället för ärende, mejl och väntan beskriver användaren uppgiften. Shortcut förstår vad som ska göras, hämtar rätt artikel och skapar ett gränssnitt med exakt det fält som behöver fyllas i. Användaren bekräftar och ändringen hamnar där den hör hemma. Samma sak gäller vardagliga uppgifter som att:
- klassificera en produkt i rätt kategori
- byta en produktbild
- översätta en produkttext
- rätta stavningen av ett namn
Tre saker är viktiga här:
- Systemen finns kvar. Datan lever fortfarande i era trygga och välstrukturerade system, och power users har kvar sina gränssnitt.
- Fler kan göra mer. Den som känner till produkten, kunden eller affären kan själv göra ändringen, utan att vara expert på systemet. Det är en demokratisering av både data och handling.
- Silos bryts utan att rivas. Shortcut arbetar över flera system samtidigt, så uppgiften styr arbetet, inte organisationsschemat.
Det finns en genväg, men den tas steg för steg
Alla pratar om AI-agenter som själva arbetar i systemen. Det är dit utvecklingen går. Men den som försöker koppla upp allt, lära AI allt och släppa kontrollen på en gång tar en stor risk. Vi tror på en kontrollerad väg i tre steg:
- Koppla upp: Ge AI tillgång till de system och den data som uppgiften kräver.
- Lär upp: Låt AI föreslå och människor bekräfta, så att lösningen lär sig hur ni arbetar.
- Tillåt: När ni litar på att det blir rätt kan AI hantera utvalda uppgifter på egen hand.
På så sätt växer förtroendet i takt med förmågan, och varje steg ger nytta i sig.
Förutsättningen: data som AI kan lita på
Här finns en paradox. Ju enklare "framsidan" blir, desto högre krav ställs på "baksidan". Data Management-kraven ökar i takt med utvecklingen av Data Experience, helt enkelt.
En människa som navigerar i ett system kan se att något ser konstigt ut och fråga en kollega. En AI som ska tolka en uppgift, hämta underlag från flera system och föreslå en åtgärd kan inte det. Den behöver data som är agent-redo:
- En källa till sanning: Det måste vara tydligt vilket system som äger kund, produkt eller leverantör. Annars får AI motstridiga svar och väljer ett av dem. Det är kärnan i Master Data Management.
- Gemensamma definitioner: "Kund" eller "produkt" kan betyda olika saker i olika delar av organisationen. Människor löser det med sunt förnuft, AI gör det inte.
- Tydligt ägarskap och regler: Vem får ändra vad, och vad kräver godkännande? Utan Data Governance finns inget för AI att följa.
- Information som stämmer i sitt sammanhang: Det räcker inte att fälten är ifyllda, de måste också vara rätt. Mer om det i vårt inlägg om datakvalitet och informationskvalitet.
Det är därför Data Management och Data Experience hör ihop. Det ena gör datan pålitlig, det andra gör den användbar. Organisationer som redan har ordning på sin masterdata och sin governance kommer att kunna ta stegen mot agentiska arbetssätt mycket snabbare än de som inte har det.
Kom igång: fyra frågor att ställa redan nu
- Var går tiden? Välj en vanlig process och mät hur mycket som är kommunikation, navigation och utförande. Svaret brukar överraska.
- Var är flaskhalsen? Finns det power users som alla måste gå via? Där finns ofta den snabbaste vinsten.
- Vilken data måste AI kunna lita på? Börja med de begrepp och den masterdata som processen bygger på, inte med allt.
- Vad känns som science fiction idag? Den uppgift som verkar omöjlig att förenkla kan redan vara möjlig. Det är ofta där det största värdet finns.
AI har redan förändrat hur vi skriver och söker. Nästa förändring handlar om hur vi arbetar tillsammans med data, över system och avdelningar. De organisationer som börjar bygga grunden nu kommer att ha ett försprång som är svårt att hämta in.
Vill ni prata AI och framtidens sätt att interagera data med oss? Tveka inte på att höra av dig!
Vanliga frågor om AI i verksamhetens processer
Data Experience handlar om hur människor hittar, förstår, använder och litar på data i sitt dagliga arbete. Där Data Management ser till att datan är korrekt och strukturerad, ser Data Experience till att den går att använda, oavsett vilket system den ligger i.
Ett gränssnitt som skapas för den uppgift som ska utföras, istället för att användaren letar sig fram i ett färdigt system. Det visar bara de fält och den information som behövs, hämtade från de system där de hör hemma.
Att den är tillräckligt korrekt, enhetlig och väldefinierad för att en AI ska kunna använda den utan människans sunda förnuft. Det kräver en tydlig källa till sanning, gemensamma begrepp och klart ägarskap, det vill säga god masterdata och Data Governance.
I de flesta fall inte. Vi tror att AI gör störst nytta när den tar fram underlag och föreslår nästa steg, medan människan och verksamhetens regler behåller beslutet. Med tiden kan AI få hantera utvalda uppgifter själv, när förtroendet finns.
I en process där mycket tid går åt till att leta, fråga och vänta, och där få personer är flaskhalsar. Kartlägg vilken data processen bygger på och se till att den håller, innan ni låter AI arbeta med den.
En chattbot svarar på frågor. En AI-agent kan också utföra handlingar, till exempel uppdatera ett värde i ett system. Steget dit kräver både pålitlig data och tydliga regler för vad agenten får göra.